上下文便宜了,知识库答错旧参数的问题还在
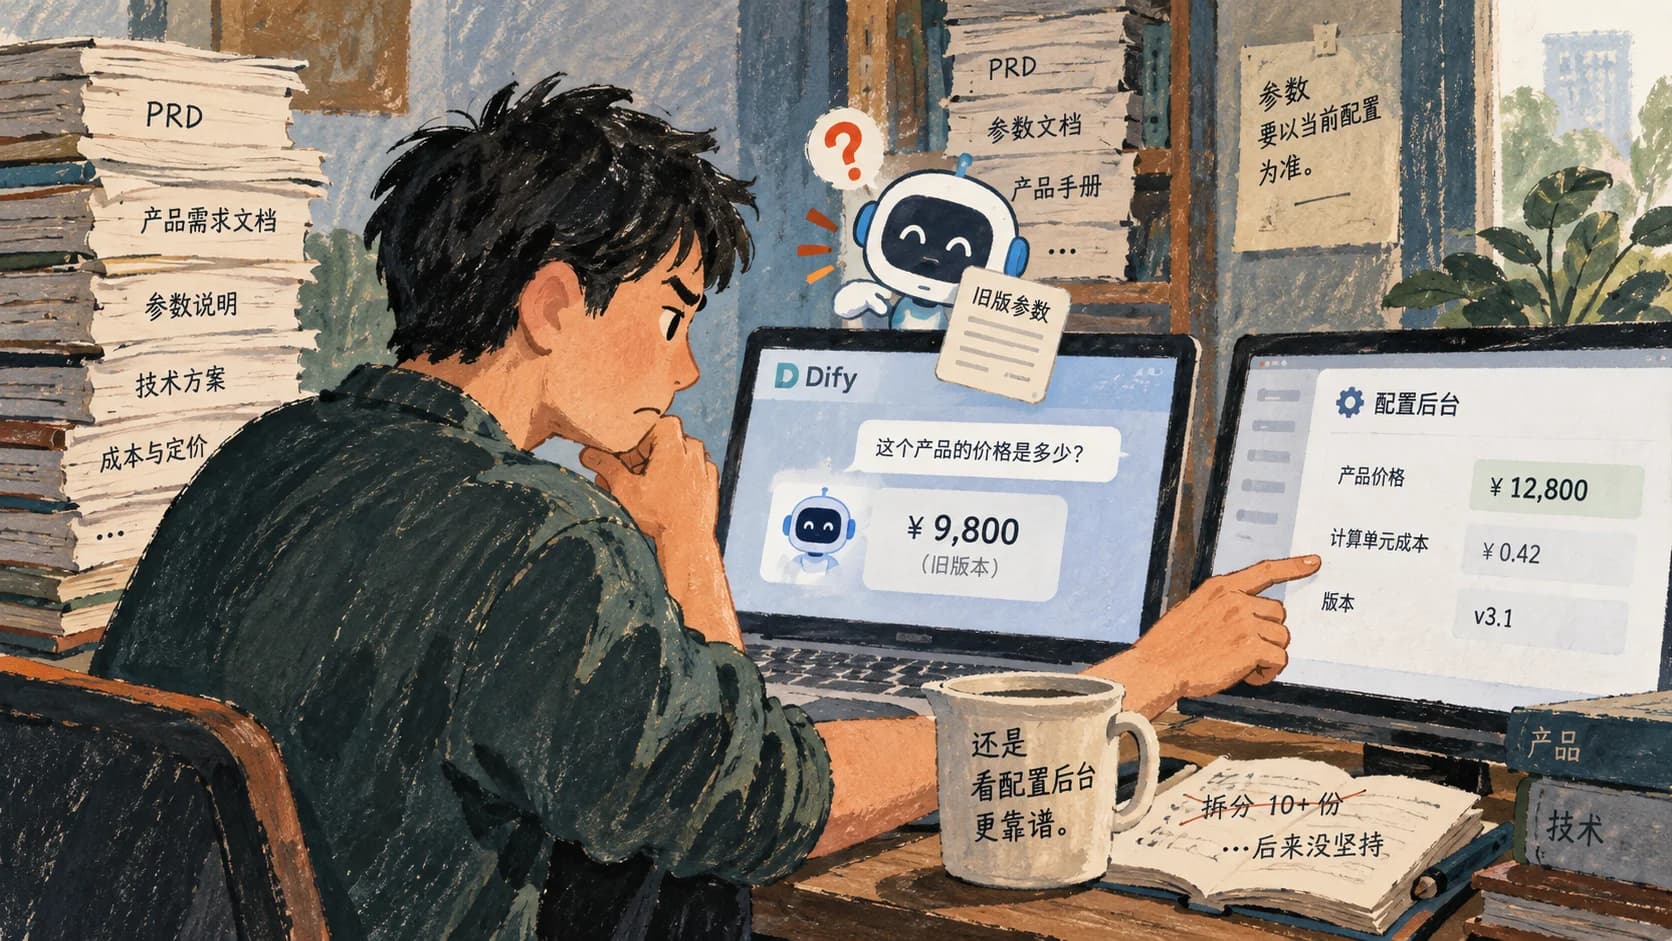
Gemini 3.1 Flash Lite 百万上下文降到每百万 token 两毛多美元。去年我在 Dify 知识问答里放了几十份 PRD 和参数文档,最典型的错是问价格或成本,答了旧版本的值,我是因为和记得的对不上才发现的。几十份里拆过十来份,后来没坚持。后来查参数,我直接看配置后台。
这个月 Google 把 Gemini 3.1 Flash Lite 的价格压到了每百万 token 0.25 美元,带一百万上下文,3.1 Pro 更是到了两百万。一年前,这个数字还要贵一个量级。
几十份 PRD 加参数文档
去年在上一家公司,我用 Dify 搭了一个内部知识问答,放进去的是几十份 PRD,加上一批参数文档。产品和研发在用,我自己查得最多:查某个功能当初怎么定的,某个模板用的什么参数。
最典型的一种错是:问一个参数,它答了旧版本的值。
那个参数确实在文档里,而且不止一处。早期的 PRD 里是一个值,后来改过,新的值写在另一份文档里。它两个都找到了,挑了一个,挑的是旧的。答得很肯定,还附上了出处。
答错的是价格和成本
答错旧版本的那几次,问的是价格或成本这类参数。
这类参数改得勤。一个模板的成本,一个功能的定价,过一段时间就会调整,每调一次,就多一个版本散在文档里。PRD 写的时候是一个数,后来的文档里是另一个数。
价格和成本还有一个特点:答错了,后果比别的参数重。拿一个旧的成本去算方案,整个方案的账都是错的。
我是怎么发现它答错的?和我记得的对不上。
这其实有点危险。我能发现,是因为那个数我碰巧记得。换一个不记得的人来问,或者换一个我没经手的参数,它答得那么肯定,还带着出处,没人会怀疑。
一个知识问答,最后要靠提问的人的记忆来兜底,说明它在最该可靠的地方,不可靠。
拆过一部分,没坚持下来
当时的办法是按模块拆,把一整篇 PRD 拆成三五百字一段,加上模板配置、模型参数这类标签,让它找得准一点。
几十份文档,拆了十来份,确实好一些。可几十份文档,每一份都要读一遍、切开、打标签,新文档进来还要照做。拆到后来,没坚持下来。
没坚持,也有一个原因是拆的活没人接。几十份文档,每一份都要读、切开、打标签,新文档进来还得照做,这件事从头到尾压在我一个人身上。
第一反应是不用拆了
看到这次降价,第一反应是:那就不用拆了,整篇扔进去,让模型自己找。
想了想,不行。
当时答错,原因不是放不下。是同一个参数在不同时间写在了不同的地方,模型不知道哪个是现在生效的。上下文长了,它能同时看到所有版本,可它未必更清楚哪个版本算数。更可能的是把几个版本揉在一起答,或者照样挑错一个。
而且百万上下文,不等于每次都该把所有文档带上。带得越多,一次调用越慢,模型在一大堆内容里找一个数,也未必比在一小段里找得准。便宜解决的是钱,没解决找。
回头看,拆本身也不是答对的关键。真正起作用的,是拆的时候顺手把内容归到了具体的模块和参数下面,范围小了,冲突的版本就少了。可版本冲突这件事,从头到尾没被正面解决过。
后来查参数,我看配置后台
还在上一家公司时,后来要查一个参数,我更常做的,是直接去看配置后台。
当时配置后台里的数,就是正在生效的那个。它不解释为什么是这个数,也不告诉我改过几次,但它不会给我一个旧的。
绕了一圈,最可靠的答案还是在系统里,不在文档里。文档记录的是某一天大家怎么想,系统里存的是现在实际是什么。问参数这类问题,本来就该问系统。
知识问答真正该回答的,是系统回答不了的那部分:为什么定这个数,当时考虑过什么,改之前是多少。
便宜下来的部分,花在版本上
所以便宜下来的这部分,我更想花在版本上。
比如不再拆了,但每份文档开头写清楚它是什么时候的,有没有被后面的文档替代;比如把参数的改动记录单独整理出来,整篇带进去,让它知道时间顺序。这些以前嫌麻烦,没做。
还有一种更省事的分工:参数不从文档里答,从配置后台里取,文档只负责解释为什么。上下文便宜了,把现在的配置和历史的文档一起带进去,让它分清哪个是现在、哪个是过去,这件事才有了做的余地。
便宜的上下文,让我可以少拆一点文档,替不了我分清版本。
上下文的价格是模型公司的事。文档里哪一句还算数,还是我们自己的事。
这个月我换到了弃疾数智科技,开始做餐参AI。