每个任务一个 Agent,我最担心的是出错难查
OpenAI 开源了编排规范 Symphony,每个任务启动一个 Codex 代理。我们的文案模块早就是写和审分开:同一个模型审自己会放水,审校退回最多的是合规和禁用词,退回后由生成模型自动重写。我自己用编码工具也按模块拆,一般同时开三四个。多个 Agent 各做一块,我最担心出错难查,真查过一次,靠的是工具自带的记录。
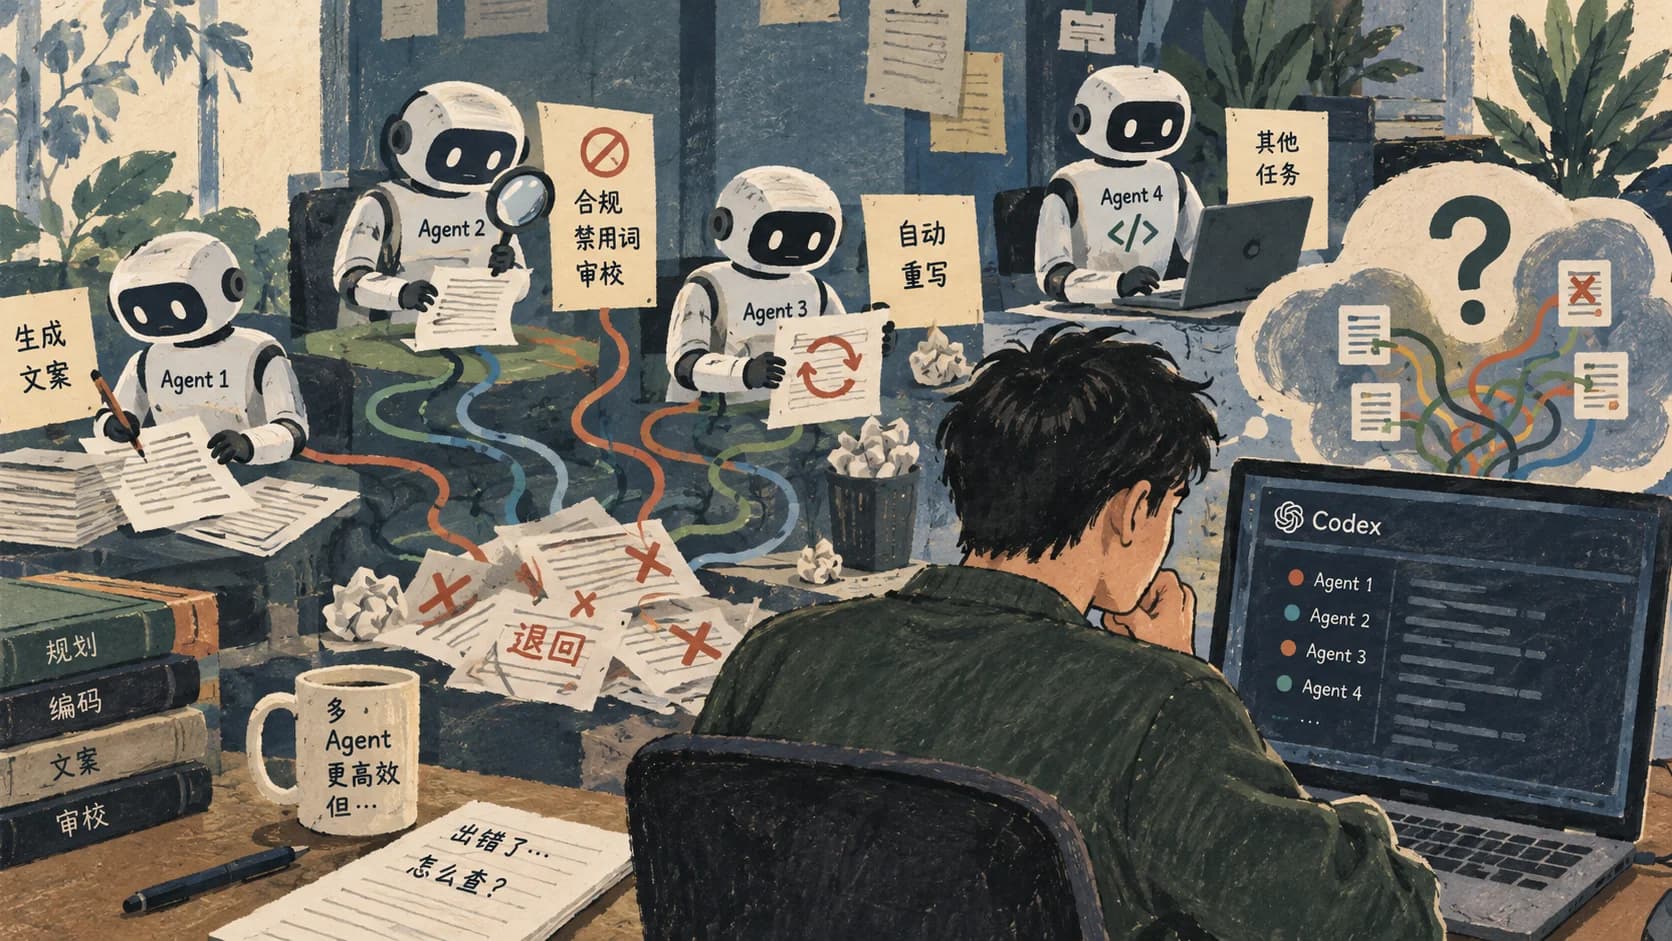
4 月底 OpenAI 开源了一个编排规范,叫 Symphony,思路是每个任务启动一个 Codex 代理,任务多就多开,做完各自收。
这个思路我不陌生。
写和审,一开始就分开了
去年做文案模块时,生成是一个模型,审校是另一个模型。当时这么分,理由很直接:同一个模型写完再自己审,会放水,它会觉得自己写得挺好。这个理由听起来简单,却是整个设计的出发点,写的人不适合当自己的审稿人,模型也一样。
审校退回以后,下一步是生成模型自动重写,重写完再审,审过了才到人手里,人最后再全部看一遍。
所以每个任务一个 Agent,在我们这里早就是这么做的,只是没有这个名字。
退回最多的,是合规和禁用词
审校打分的四个维度里,退回最多的是合规和禁用词。
这一点挺说明问题。生成模型写得通顺,关键词也放了,事实大体也对,最容易出事的,是它不知道哪些话在平台上不能说。这些规则是平台定的,会变,有的还很细,生成的时候就算带着规则写,也难免漏。
禁用词还有一个特点:错一句,可能整条都上不了架。其他维度扣分,是写得好不好;这个维度出事,是能不能用。
所以审校这个 Agent,最重要的工作其实很窄:拿着一份规则,一句句对。窄,恰恰适合单独拆出来。让写的人同时记着几十条禁用规则,和让一个专门的角色只盯这一件事,后者稳得多。
我自己用编码工具,也按模块拆
我自己用 Codex 和 Claude Code 的时候,也会把一个任务拆给几个代理,按模块拆,一般同时开三四个,各做各的。
拆开的好处很明显。每个代理面对的范围小,说清楚要什么容易,做出来的东西也更集中。几个同时跑,时间也省。
为什么是三四个
同时开三四个,不是越多越好算出来的,是我看得过来的上限。
每个代理跑一阵,会停下来等确认,或者做完了等我看。开得太多,它们在那里排队等我,我反而成了最慢的那一环。三四个,差不多是我能同时照看、又不让它们等太久的数。
这也说明一件事:并行的上限,常常不在机器,在看结果的人。
最担心的是出错难查
但拆多了,我最担心的是出错难查。
一个代理做错了,如果错就在它那一块,找到它就行。可很多时候,错不在任何一块里,在块和块之间:一个代理改了一个名字,另一个还在用旧的;一个以为另一个会处理某件事,另一个也这么以为。
三四个同时跑的时候,这种事更容易发生。它们各自拿着任务开始,谁也不知道另一个此刻改到了哪。
最后结果不对,回头去查,要一块块看。每一块单看都对,合在一起就是不对。
文案模块那个退回重写的循环,也是一样的道理。转了几圈以后出来的文案如果有问题,要追是哪一轮开始走偏的,就得把每一轮的输入输出都翻出来。
真查过一次
块和块之间的问题,我真查过一次。
那次结果不对,几个代理各自的部分看着都没问题。我顺着工具自带的记录往回翻,看每个代理改了什么、改之前是什么样,很快就找到了,问题果然出在两块接头的地方。
找得快,是因为改动不大,记录也还在。如果改动多,或者记录没留,就是另一回事了。
现在我也不专门要求每个代理留记录,靠的是工具自带的那一份。够用,但我知道它是工具替我留的,留什么、留多久,不由我定。这次经历让我对拆任务放心了一点,也警惕了一点。
框架没写的那一段
Symphony 把这件事推得更远:不只是写和审分开,每一件小事都是一个独立的代理。好处是互不干扰,一个坏了不影响别的;代价是出了问题,要从一堆独立的记录里拼出发生了什么。
所以我看这类编排框架,关心的不是能开多少个代理,是出错了怎么查:每一步留下了什么,能不能顺着一条线追回去。框架没写这一段,得自己补。
对文案模块,我们的做法是退回的时候说清楚退的是哪一句、为什么。这不只是为了下一轮改得准,也是为了出了问题以后,能顺着退回的理由往回找。