成本降了三十五倍,文案模块的难处本来就不在钱上
OpenAI 发 GPT-5.5,说 token 成本降到三十五分之一。我之前做的文案模块里,一条商品文案生成两三版再挑,审校之后运营还要全部看一遍,一条一两分钟,成本从来不在模型上。便宜下来,我第一个想让它多做的,是自己对一遍事实表,把最常见的夸大卖点先标出来。
4 月 24 日 OpenAI 发了 GPT-5.5,宣传里有一句:token 成本降到三十五分之一。
看到这个数字,我第一反应是去想以前那个文案模块的账。想完发现,这笔账跟这个数字关系不大。
成本从来不是问题
文案模块里,成本从来不是问题。
一条商品文案,当时是生成两三版,再挑。审校之后,运营还要全部看一遍,一条大概一两分钟。模型调用的钱放在整个流程里,占比很小,小到没人专门去算。
真正贵的,是人看的那一遍。每一条都要看,看的人要懂平台规则,要懂商品,要知道哪句话放在哪个平台会出事。这部分的成本,token 降多少倍都不会变。
一两分钟一条,贵在哪
人看一条文案,大概一两分钟。
一两分钟听起来不长。可每一条都要看,每天要出的文案又多,加起来就是运营一整天的工作。模型生成两三版,几秒钟;人看一条,一两分钟。两边差了几十倍。
这就是为什么 token 降价在这里没什么感觉。流程里最慢、最贵的那一段,是人。模型那段本来就快,本来就便宜,再便宜三十五倍,整条流程几乎看不出变化。
那降价改变了什么
所以对文案模块来说,成本降三十五倍,省钱这件事几乎没有意义。
有意义的是另一件事:以前没让模型多做的检查,现在可以让它做了。说没舍得也不准确,更像是以前没往这边想,因为每多一步,都得先想想值不值。现在不用想了。说到底,这是一次顺序的变化:以前先想值不值,再决定要不要加检查;以后可以先加检查,看效果再说。
两三版里挑一版
生成两三版再挑,是文案模块里最像花钱买质量的地方。
便宜三十五倍以后,生成十版也不贵。可加到十版,意义不大。
版本多了,挑的人更累。两三版,一眼能比;十版,要一条条读。省下的是 token,多出来的是人的时间。这笔账和前面一样,还是人那一段说了算。
第一个想让它多做的,是对一遍事实表
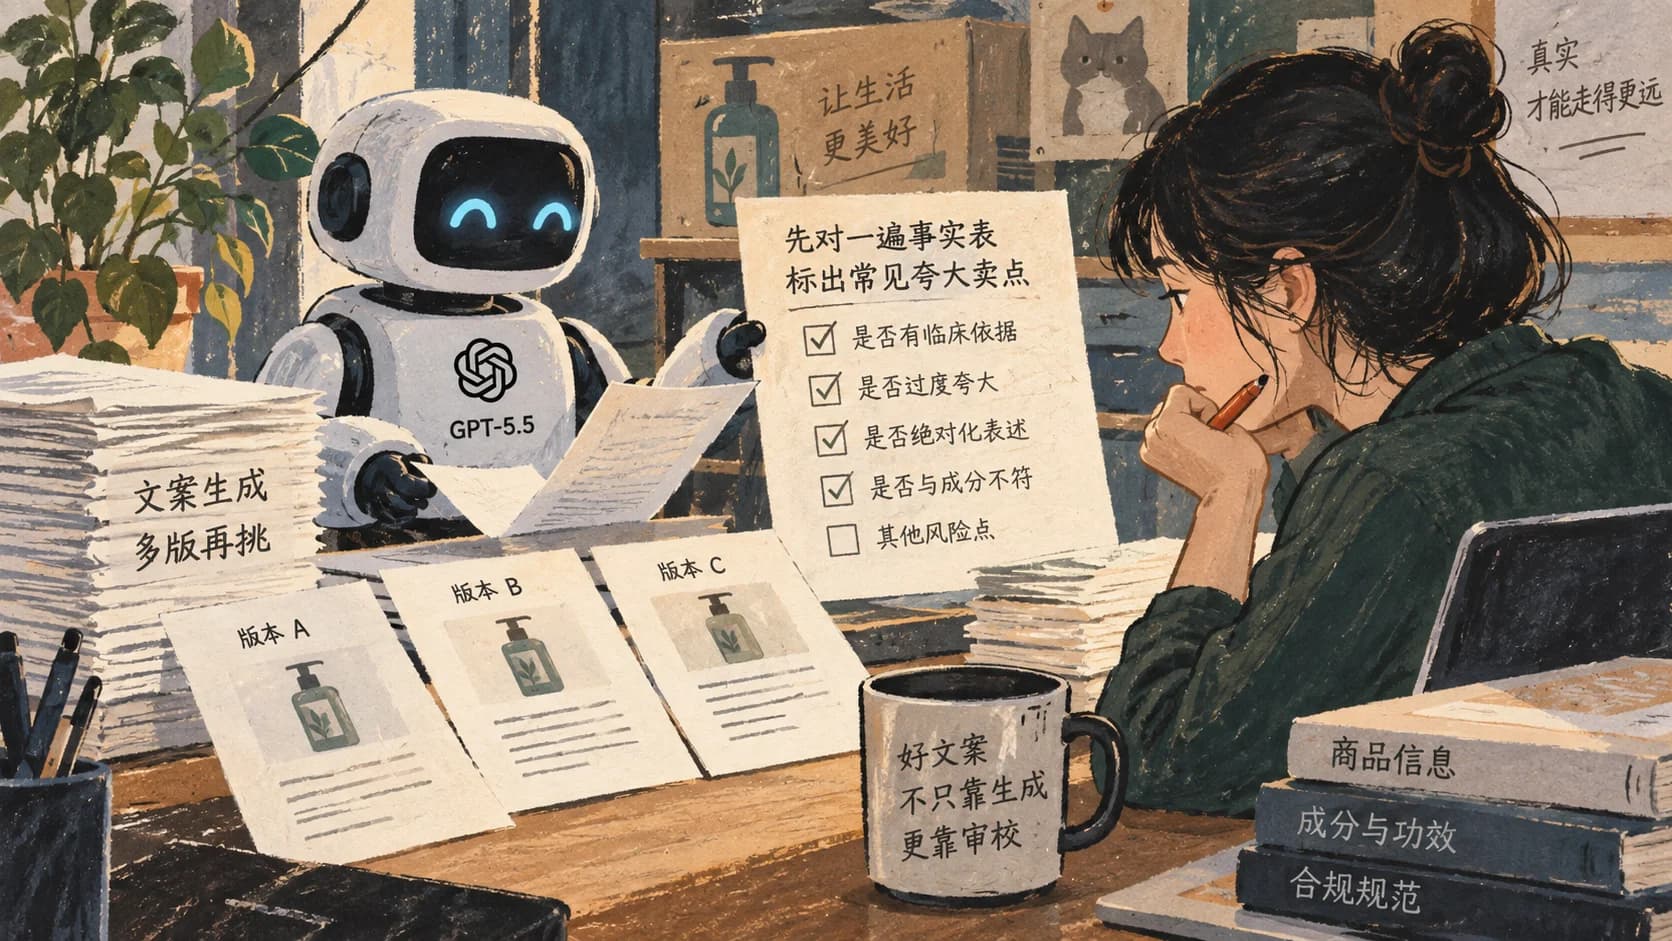
便宜下来,我第一个想让它多做的,是自己对一遍事实表。
那套文案流程,生成前有一份 Product Fact Sheet,基础参数、卖点材料、平台禁用词和合规限制都在里面,模型按它来写。可写出来的东西里,还是会有一两句是事实表里找不到的,最常见的是夸大的卖点:资料里说的是一件事,写出来变成了更厉害的一件事。
这些句子,当时是人看的时候去找。人找得出来,但要一句句对,这是那一遍人工里最费劲的部分。
如果让模型写完以后,自己拿着事实表对一遍,把找不到来源的句子标出来,人看的时候就不用从头对,先看标出来的那几句就行。它对得不一定准,可只要能把大部分对不上的句子挑出来,运营就能把一两分钟,花在最该花的地方。
夸大的卖点,最难找
事实表里找不到来源的句子,最常见的是夸大的卖点。
这类句子最难找。一个参数写错了,对着事实表一查就知道;一个卖点被写大了,每个字都挑不出毛病,只是比资料里说的更厉害一点。比如资料里说耐用,写出来成了超耐用;资料里说适合户外,写出来成了专为户外设计。
运营一两分钟里,最费神的就是这一类。它不是错,是过了。过多少算过,要靠经验。这类句子读起来往往更有劲,更像卖货的文案,光靠读,很难读出问题,只能对照资料拦下来。
如果模型能先对一遍,把和事实表对不上的地方标出来,这类句子就有了一个起点:它至少知道资料里原话是什么,写出来的比原话多了多少。
人还是要看
这不会让人不看。审校之后人全部看,短期内不会变,因为出了事,担后果的是人。运营,担的是出了事的责任。模型标出来的,他可以先看;没标出来的,他也不能不看。
但人看的东西可以变:从每一句都要核,变成先看被标出来的那几句,再扫一遍整体。看的时间短一点,漏的也少一点。
成本降三十五倍,模型公司讲的是它的故事。我的故事小得多:一个以前没往那边想的检查,现在可以做了。