把失败图分进格子以后,可用率从 50% 走到了 72%
今年 Smart Photo 的可用率从 30% 做到 50% 就停住了。我把失败图整理成一张表,一边是服装、3C、家居、家纺,一边是形态、材质、场景,然后才有了分品类训练。后来做到了 72%,但我不打算把功劳全记给拆分。
目录
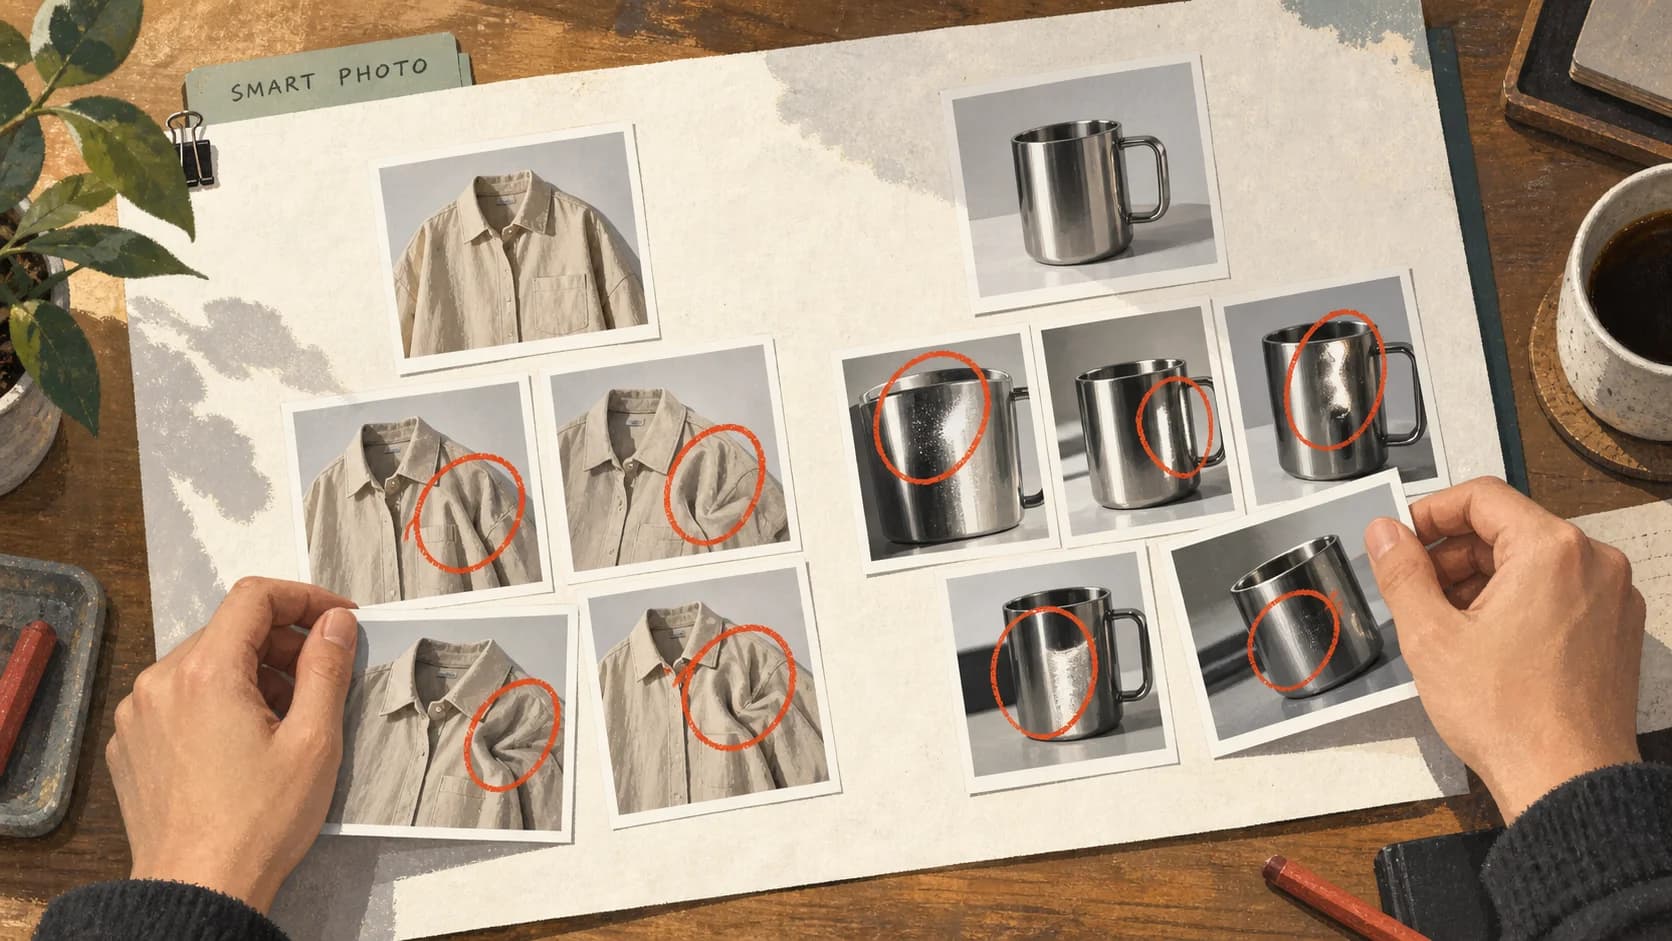
做 Smart Photo 的商品图时,看失败图片是绕不开的活。今年可用率从 30% 做到 50%,然后停住了。看得多了,不同品类出问题的地方明显不一样,分品类训练的念头也是从那时候起的。拆开以后,做到了 72%。
现在回看,我还不能把改善全部归到拆分上。如果把过程理解成“看出规律,拆开模型,效果就好了”,分类好像只是为了证明已经选中的方案。它真正值得展开的地方,是失败被分开以后,下一步有哪些不同的可能,为什么不能只凭一组看起来相似的问题,就认定找到了原因。
一张图不达标,可以让这张图退出候选,却不能告诉团队该改什么。商品形态不对、材质表现不对、场景不适合,都可以归进“不能用”,但把它们放在一起要求继续提升效果,讨论还是很空。知道有多少图不能用是一种信息;知道哪些问题值得分别处理,是另一种。
那张表
当时整理的是一张表:一边是品类,服装、3C、家居、家纺;另一边是失败类型,形态、材质、场景。每张失败图落进一个格子,再数每个格子有多少、对应哪个模型版本。沿着这张表往下分析,才谈得上分类和验证该怎样展开。
我会先警惕分类名称带来的暗示。把一组图片叫作“材质失真”,描述的是看到了什么;叫作“训练数据不足”,已经在解释为什么会这样。两种话都可能有用,但不能写在同一栏里当成同样确定的事实。否则大家一看分类表,就已经被带向补数据,其他可能性甚至没进入讨论。
品类也有类似的问题。按品类分开,便于看到差别,却不代表品类就是错误的原因。某种问题在一类商品中多,可能与商品的视觉特点有关,也可能与输入图、使用的场景或样本构成有关。它提示值得继续查,还没证明把模型拆开就一定能解决。分类最先提供的是一个更小、更具体的问题,不是一句技术结论。
假设有一批失败图,某种表面质感总是表现不对。若这些图同时都用了相近的光照场景,就需要把品类差异和场景差异分开想。换个场景就不再明显,后续方向可能偏向场景控制;换场景后仍反复出现,才有理由继续追问商品特征的适配。不能因为分类表的第一列是品类,后面的分析就只沿着品类走。
我也会想看那些没有失败的图。同一类商品里,什么条件下能做好,本身就能缩小问题范围。同一种材质在某个角度表现正常,另一个角度不稳定,那么“这一品类都不行”就太宽了。只看坏图容易把问题放大成整类能力缺失,对照能用的结果,反而可能找到一个更小的调整范围。
数量需要有分母。某类失败图最多,可能是因为这类生成得最多;某种问题看起来集中,也可能是同一个商品反复重试留下的相似结果。仅凭失败图的数量,排不出哪一类最严重。分类以后仍要分清在数图片、商品,还是独立的生成任务。
补数据,还是拆开
这些限制不是说发现品类差别没有价值。它至少让“继续优化”不再是唯一能说的话。可以讨论是否补某一类缺少的样本,是否先调整某种场景要求,是否检查输入处理,也可以把分品类训练拿出来比较。它们未必相互排斥,但投入的地方不同,预期解决的问题也不同。
补数据这条路不能因为后来选了拆分,就被当成一个显然错误的选项。某个范围缺少足够覆盖,补充合适的样本仍然可能有帮助。问题是补什么,不只是总量增加多少。反过来,即使补过一批数据而结果没有明显变化,也还要知道新增内容、训练设置和比较方式,不能据此得出“加数据无效”。
分品类训练值得考虑的地方,是可以分别调整不同商品范围的适配,不必要求所有差异都在同一套设置里处理。但按业务品类分组,是否恰好适合训练,需要技术侧判断。视觉特征接近的商品可能跨品类,单个品类内部也可能差异很大。目录上的分类方便管理,不一定就是最合适的模型边界。
拆开还可能让每份数据覆盖变窄。这不等于拆分一定不好,而是要问清原来放在一起的素材,哪些提供了可以共享的信息,哪些确实需要区别处理。如果只是为了让方案和分类表一一对应,就给每个标签各配一个模型,分析看起来非常完整,维护也可能跟着变得很重。
我更想把这种额外工作展开,而不是用“多训几个模型”一句带过。不同范围各自训练以后,需要知道用哪份数据、怎样验收、某个场景该调用哪一版。新增商品怎么归入,边界不清的商品怎么办,某一版更新后谁来检查,都是方案要回答的后续问题。维护的代价还会出现在版本比较上。某一类可以单独更新,其他范围不必一起等待,这是便利;但共享的处理步骤一旦变化,仍可能影响多个模型。拆分不代表风险也自动分开。
先在一个范围里验证
值得比较的,不只是统一训练和全部拆开两个完整方案。也可以先在差异比较明确的范围里验证分开处理,其他部分保持原来的方式。它的意义在于先回答一个较窄的问题:针对这类失败,单独适配是否确实有帮助,是否值得承担后续成本。
这个验证不能只挑原来那几张失败图。只针对已经看过的图调整,再用它们证明有效,很难知道改善能否延伸到别的商品。原来的难例值得保留,同时还需要相近但没有参与调整的输入,以及此前表现正常的范围。后者不是陪衬;修好一类问题的同时有没有损失别的能力,同样影响方案能否接受。
比较时,我希望尽量保留其他条件。数据、提示词和生成控制一起改,最后的图也许更好了,但它只能支持整套方案有所变化,不能精确说明拆分贡献了多少。工程上有时需要多个改动一起推进,未必能逐项单独验证。能明确记录哪些条件同时变了,就比事后给改善寻找一个单独的原因可靠。这也是我对“50% 到 72%”这个数字保持一点距离的原因。
决定下一步,不一定要等所有原因都被证明。一个有限范围的尝试成本可以承受,即使还没掌握完整解释,也可能值得验证。但验证之前应当知道自己在等什么:希望哪类失败减少,哪些正常表现不能退步,出现什么结果说明这条路暂时不值得扩大。
失败分类还会影响先处理哪一组。最常出现的问题值得重视,未必总是第一顺位。一种失真会改变商品关键信息,另一种只是让背景不够理想,两者都不能直接交付,后续处理难度和误用风险却可能不同。我倾向把影响、发生范围和修正代价一起看,而不是默认最大的一堆就最值得先训练。
也有一些分类暂时无法导向修改。样本太少,判断有分歧,或者现有信息看不出共同条件,都可能使下一步停在补充观察。这不算分类没有产出。至少团队知道哪一组能开始比较方案,哪一组还只能提出问题。
我想留下的是分类怎样改变下一步的讨论。原来只能问“效果还不够好怎么办”,现在可以问“这组问题在哪些条件下出现,先改哪一处最值得验证”。问题变具体以后,补数据、调整控制、分开适配,才有了可以相互比较的依据。即使当时没有选拆分,这份分类仍然有用,因为它帮助缩小了要处理的范围,而不只是替某个方案提供赞成票。